Resumen
El análisis inicial no mostró una vulnerabilidad crítica aislada. La superficie empezó a ser relevante al correlacionar inconsistencias de autorización a nivel de objeto, dependencias legacy, identidades de servicio con un alcance superior al requerido y políticas cloud cuyo permiso efectivo no coincidía con su función nominal.
El compromiso no dependía de un único fallo, sino de cómo varios controles razonables de forma local dejaban de serlo al componerse dentro de la misma arquitectura.
El objetivo de este writeup es documentar cómo se reconstruyó el grafo de confianza entre componentes, qué señales permitieron priorizar activos y en qué punto la exposición dejó de ser un problema de aplicación web para convertirse en un problema de identidad e infraestructura.
Algunos identificadores, valores, rutas y elementos de arquitectura se han modificado u omitido. El objetivo es explicar la cadena técnica y el modelo de confianza, no reproducir detalles operativos innecesarios.
1. Modelo de la superficie
La primera fase no consistió en lanzar una enumeración indiscriminada, sino en construir un modelo mínimo de la superficie expuesta y de las relaciones que podían existir entre activos actuales y componentes históricos.
El dominio principal exponía una aplicación SaaS, una API pública y varios endpoints relacionados con autenticación. La mayor parte del tráfico estaba mediada por una capa perimetral y no existían servicios administrativos evidentes publicados directamente.
La hipótesis inicial era que el riesgo más interesante no estaría necesariamente en el frontend actual, sino en la diferencia entre la arquitectura que la organización consideraba vigente y los activos que todavía seguían resolviendo, aceptando tráfico o compartiendo dependencias con producción.
Internet
  |
  +-- app.northstar.tld
  +-- api.northstar.tld
  +-- auth.northstar.tld
  |
  +-- activos históricos / no documentados
Un activo antiguo no es relevante por ser antiguo. Se vuelve relevante cuando conserva relaciones de confianza con servicios actuales, utiliza credenciales heredadas, resuelve nombres internos o expone comportamiento que ya no existe en la aplicación moderna.
2. Asset discovery y passive enumeration
La enumeración se centró en señales de continuidad operativa, no en acumular subdominios. Certificados históricos, convenciones de naming, referencias residuales en recursos estáticos y documentación indexada permitieron identificar activos que ya no formaban parte del flujo principal, pero que seguían teniendo presencia operativa.
Uno de esos activos destacaba por tres motivos: seguía resolviendo, aceptaba una sesión válida del ecosistema actual y utilizaba una versión de API distinta a la consumida por la aplicación moderna.
Eso reducía mucho el espacio de búsqueda. En lugar de tratarlo como una aplicación independiente, lo traté como una posible ventana a un modelo de confianza anterior.
portal-legacy.northstar.tld
        |
        v
      API v1
        |
        v
integración heredada
El hecho de que un activo esté desactualizado o fuera del inventario visible no lo convierte por sí solo en un riesgo crítico. Lo relevante es si conserva autenticación válida, dependencias compartidas o acceso a servicios que siguen perteneciendo al entorno actual.
3. Autenticación correcta, autorización incompleta
El servicio validaba correctamente la identidad del usuario. La sesión era legítima y el token solo era aceptado dentro del flujo esperado. El comportamiento anómalo aparecía después, al resolver determinados recursos asociados a un workspace.
Algunos handlers verificaban que el recurso solicitado perteneciese al tenant del usuario autenticado. Otros confiaban únicamente en que el identificador recibido fuese válido.
La diferencia es importante: la autenticación respondía correctamente a quién era el usuario, pero la autorización no siempre comprobaba si ese usuario podía operar sobre el recurso solicitado.
| Recurso | Autenticación | Tenant check | Observación |
|---|---|---|---|
| /profile | Sí | Sí | Control consistente |
| /billing | Sí | Sí | Control consistente |
| /workspace/configuration | Sí | No | Recurso resoluble fuera del tenant |
| /workspace/integrations | Sí | Parcial | Política dependiente del handler |
| /workspace/members | Sí | Sí | Control consistente |
La señal relevante no era únicamente el acceso cruzado a un objeto. Era la inconsistencia entre endpoints que operaban sobre la misma entidad.
Cuando dos rutas que deberían compartir la misma política de seguridad aplican controles distintos, normalmente existe una duplicación de lógica, una migración incompleta o una frontera de autorización que no está centralizada.
Una API puede estar correctamente autenticada y seguir teniendo un modelo de autorización débil.
4. De datos de aplicación a metadatos de arquitectura
La respuesta afectada no contenía credenciales ni secretos directamente utilizables. Contenía configuración.
Eso cambia bastante el tipo de análisis. El valor de esos datos no estaba en su sensibilidad individual, sino en cuánto reducían la incertidumbre sobre la arquitectura.
Entre los campos devueltos aparecían nombres de servicios, regiones, perfiles de integración, convenciones internas y referencias a recursos que no eran visibles desde la aplicación principal.
{
  "workspace": "prod-eu",
  "region": "eu-west",
  "integration_profile": "sync-worker-v2",
  "credential_source": "legacy-shared",
  "storage_class": "objects-internal"
}
Ninguno de esos valores era crítico por separado. En conjunto permitían inferir relaciones entre componentes y distinguir qué elementos pertenecían al flujo normal de usuario y cuáles formaban parte de procesos internos.
La referencia a legacy-shared era especialmente relevante. No era una credencial, sino una pista sobre el modelo de autenticación entre servicios.
Si una integración moderna seguía resolviendo una fuente de credenciales heredada, existía una posibilidad razonable de que varias generaciones de la plataforma continuasen compartiendo una misma identidad o, al menos, un mismo mecanismo de confianza.
La información de configuración no siempre es sensible por su contenido. A veces lo es porque revela cómo están conectados los sistemas.
5. Reconstrucción del grafo de confianza
A partir de ese punto dejé de analizar endpoints de forma aislada y empecé a representar relaciones entre identidades y servicios.
La pregunta ya no era qué ruta era vulnerable, sino qué identidad era aceptada por qué servicio, qué permisos obtenía al autenticarse y si ese alcance coincidía con la función que supuestamente debía desempeñar.
Usuario autenticado
|
v
API legacy
|
v
Perfil de integración
|
+------> Sync gateway
| |
| v
| Identidad de servicio
| |
| +------> Config service
| +------> Object storage
| +------> Internal API
|
+------> Fuente de credencial heredada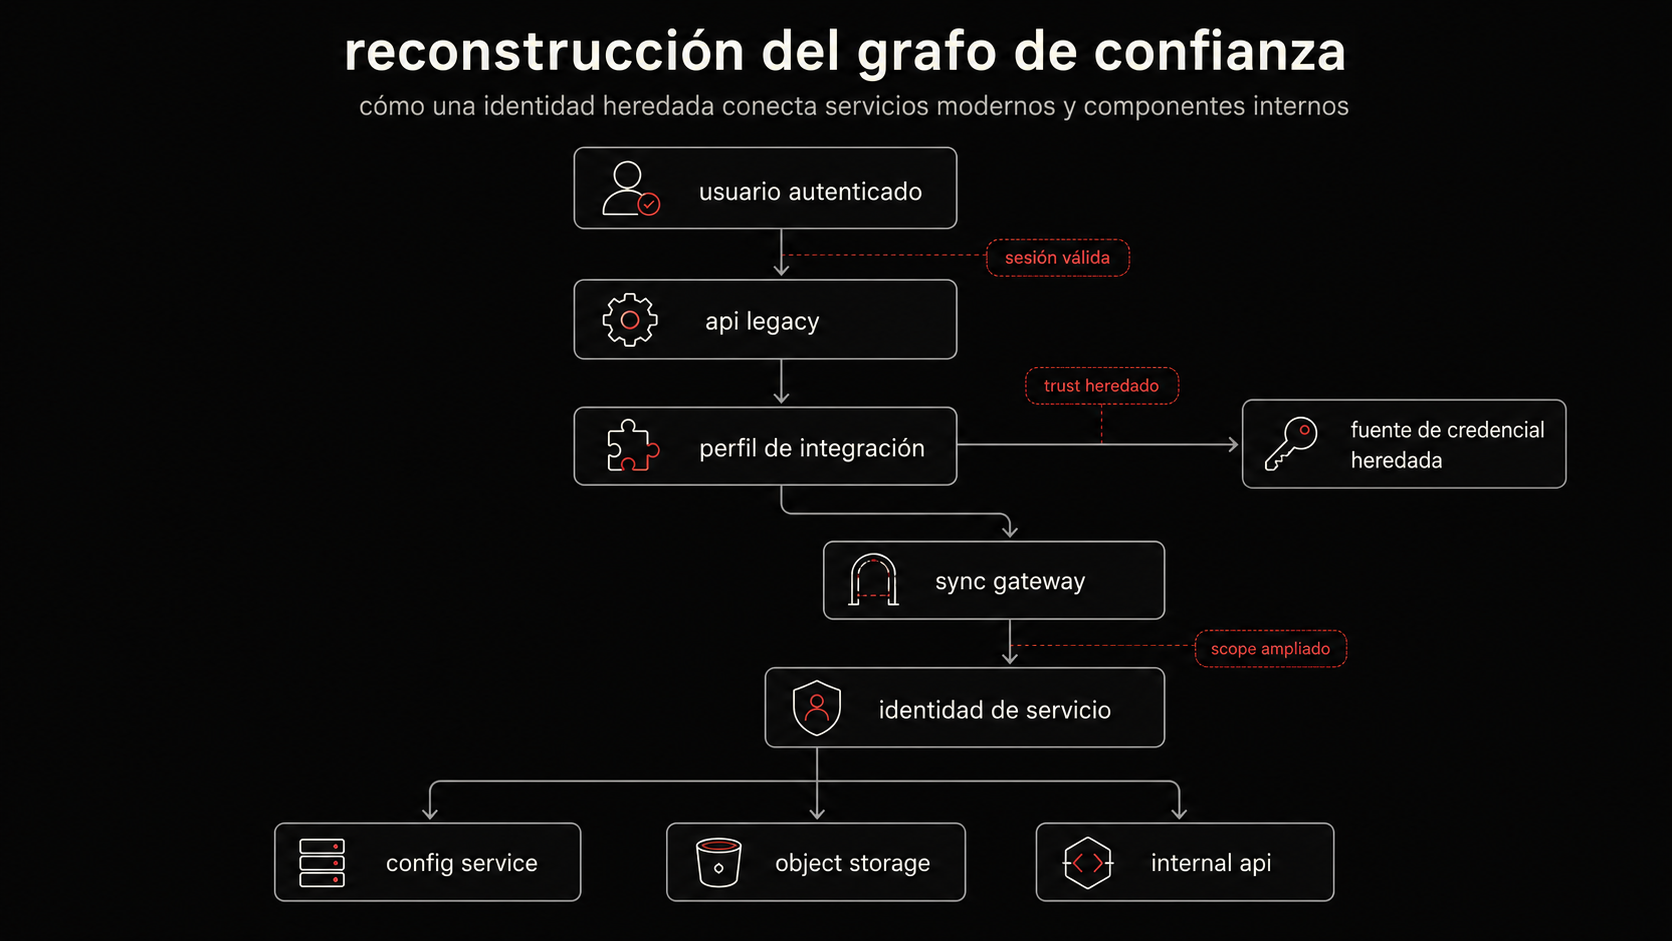 Este modelo separaba tres propiedades que en la implementación estaban parcialmente mezcladas: identidad, autenticación y autorización.
Una identidad podía ser legítima y estar correctamente autenticada, pero seguir teniendo un alcance superior al necesario. El problema no era que el sistema no supiese quién estaba realizando la petición, sino que confiaba demasiado en determinadas identidades una vez aceptadas.
El punto importante no era encontrar una credencial. Era entender hasta dónde se propagaba la confianza asociada a esa credencial.
6. Credential scope y propagación de privilegios
La credencial heredada no correspondía a una cuenta humana ni a un usuario administrativo. Era una identidad de servicio utilizada para autenticación entre workloads.
Eso hacía que el análisis fuese distinto al de una contraseña reutilizada. El problema no era únicamente la reutilización del secreto, sino el alcance efectivo de la identidad asociada y el número de componentes que seguían aceptándola.
Durante la migración de servicios, esa identidad había terminado siendo válida en más de una zona de la plataforma. El resultado era una frontera de confianza mucho menos estricta de lo que sugería la segmentación lógica entre componentes.
Servicio A
   |
   | identidad X
   v
Servicio B

Servicio C
   |
   | identidad X
   v
Servicio D
Si varias aplicaciones aceptan la misma identidad, comprometer esa identidad no afecta únicamente al servicio donde se obtuvo. Afecta a todo el conjunto de componentes que la consideran legítima.
Desde el punto de vista de seguridad, eso convierte una credencial compartida en un mecanismo de propagación de privilegios.
La segmentación de red seguía existiendo, pero no era suficiente para aislar los distintos dominios de confianza. Una identidad válida en ambos lados de una frontera puede reducir considerablemente el valor de esa segmentación.
La separación entre servicios no depende solo de la red. También depende de que cada servicio tenga una identidad distinta y un alcance limitado.
7. Del data plane al control plane
La identidad descubierta era aceptada por componentes relacionados con sincronización, diagnóstico y gestión de integraciones.
Esas funciones no pertenecían al flujo habitual de un usuario final. Formaban parte de operaciones internas necesarias para administrar la plataforma.
La diferencia puede entenderse separando dos planos.
Data plane
--------------------------------
usuarios
workspaces
datos de clientes
operaciones normales de la aplicación
Control plane
--------------------------------
configuración
integraciones
jobs internos
identidades de servicio
secretos
operaciones administrativas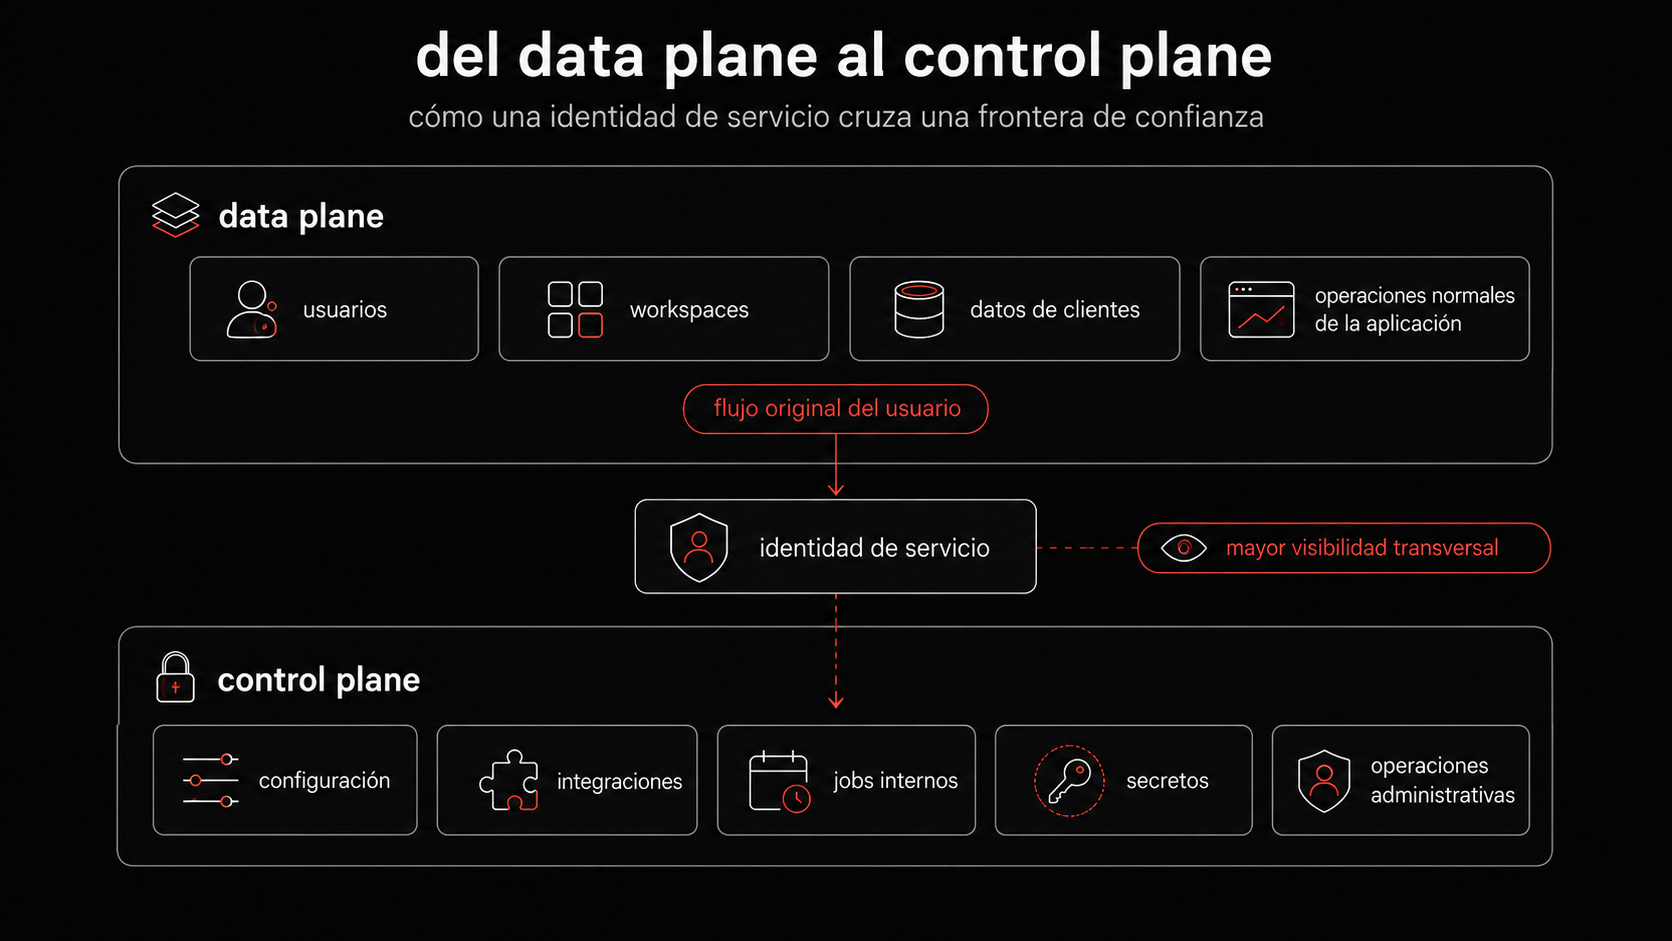 El usuario original operaba dentro del data plane. La identidad de servicio permitía interactuar con componentes del control plane.
Ese cambio era más importante que obtener acceso a una ruta adicional. El control plane suele tener visibilidad transversal sobre recursos que el data plane mantiene aislados por tenant.
Una identidad que cruza esa separación puede convertir un fallo inicialmente limitado a un workspace en un problema de alcance considerablemente mayor.
El salto relevante no fue de un endpoint a otro. Fue de una identidad orientada a usuario a una identidad con capacidad operativa sobre la plataforma.
8. Evaluando el blast radius
Antes de continuar, necesitaba saber qué podía hacer realmente esa identidad.
El nombre de un rol o de un servicio no describe necesariamente sus permisos efectivos. Para medir el impacto era necesario comparar la función esperada del workload con los recursos que podía alcanzar en la práctica.
La identidad estaba diseñada principalmente para sincronización. Sin embargo, su contexto operativo incluía acceso a configuración y a varios recursos compartidos.
Función esperada
    |
    +-- sincronización de objetos
    +-- lectura de configuración propia


Alcance efectivo observado
    |
    +-- configuración
    +-- servicios internos
    +-- recursos compartidos
    +-- material de autenticación asociado
Esa diferencia entre función nominal y alcance efectivo definía el blast radius.
El riesgo no dependía únicamente de los permisos individuales, sino de cuántos dominios de confianza podían alcanzarse desde una misma identidad.
El blast radius de una credencial no lo define dónde se utiliza primero, sino todos los lugares donde sigue siendo aceptada.
9. Secret propagation y alcance efectivo
Los procesos del control plane necesitaban material de autenticación para comunicarse con servicios internos. El almacén de secretos no era accesible de forma indiscriminada, pero la identidad de servicio sí podía resolver valores asociados a su contexto operativo.
La diferencia es importante. No se trataba de enumerar un secret store completo, sino de observar qué material podía obtener una identidad que, originalmente, solo debía realizar una función concreta.
DATABASE_URL
OBJECT_STORAGE_ENDPOINT
SERVICE_TOKEN
INTERNAL_API_URL
La presencia de estos valores no se evaluó como una colección de secretos aislados. Lo relevante era la propagación de confianza que introducían.
Cada secreto podía representar una nueva relación de autenticación. Por tanto, el análisis consistía en determinar qué servicio aceptaba cada identidad, qué permisos obtenía y si esos permisos mantenían el mismo límite de confianza que el workload original.
En otras palabras, el problema no era únicamente la exposición del secreto, sino la capacidad de ese secreto para extender el contexto de ejecución hacia componentes que nunca debieron ser alcanzables desde la ruta inicial.
Un secreto solo es tan limitado como el conjunto de sistemas que lo aceptan.
10. Effective IAM permissions
La siguiente fase consistió en comparar los permisos nominales de la identidad con sus permisos efectivos sobre infraestructura cloud.
El servicio de sincronización requería acceso a un conjunto concreto de objetos. Sin embargo, la política asociada había crecido con el tiempo y cubría recursos que no formaban parte de su responsabilidad.
Permisos requeridos
customer-imports/*
read
write
Permisos efectivos
objects/*
customer-imports/
exports/
backups/
internal/
analytics/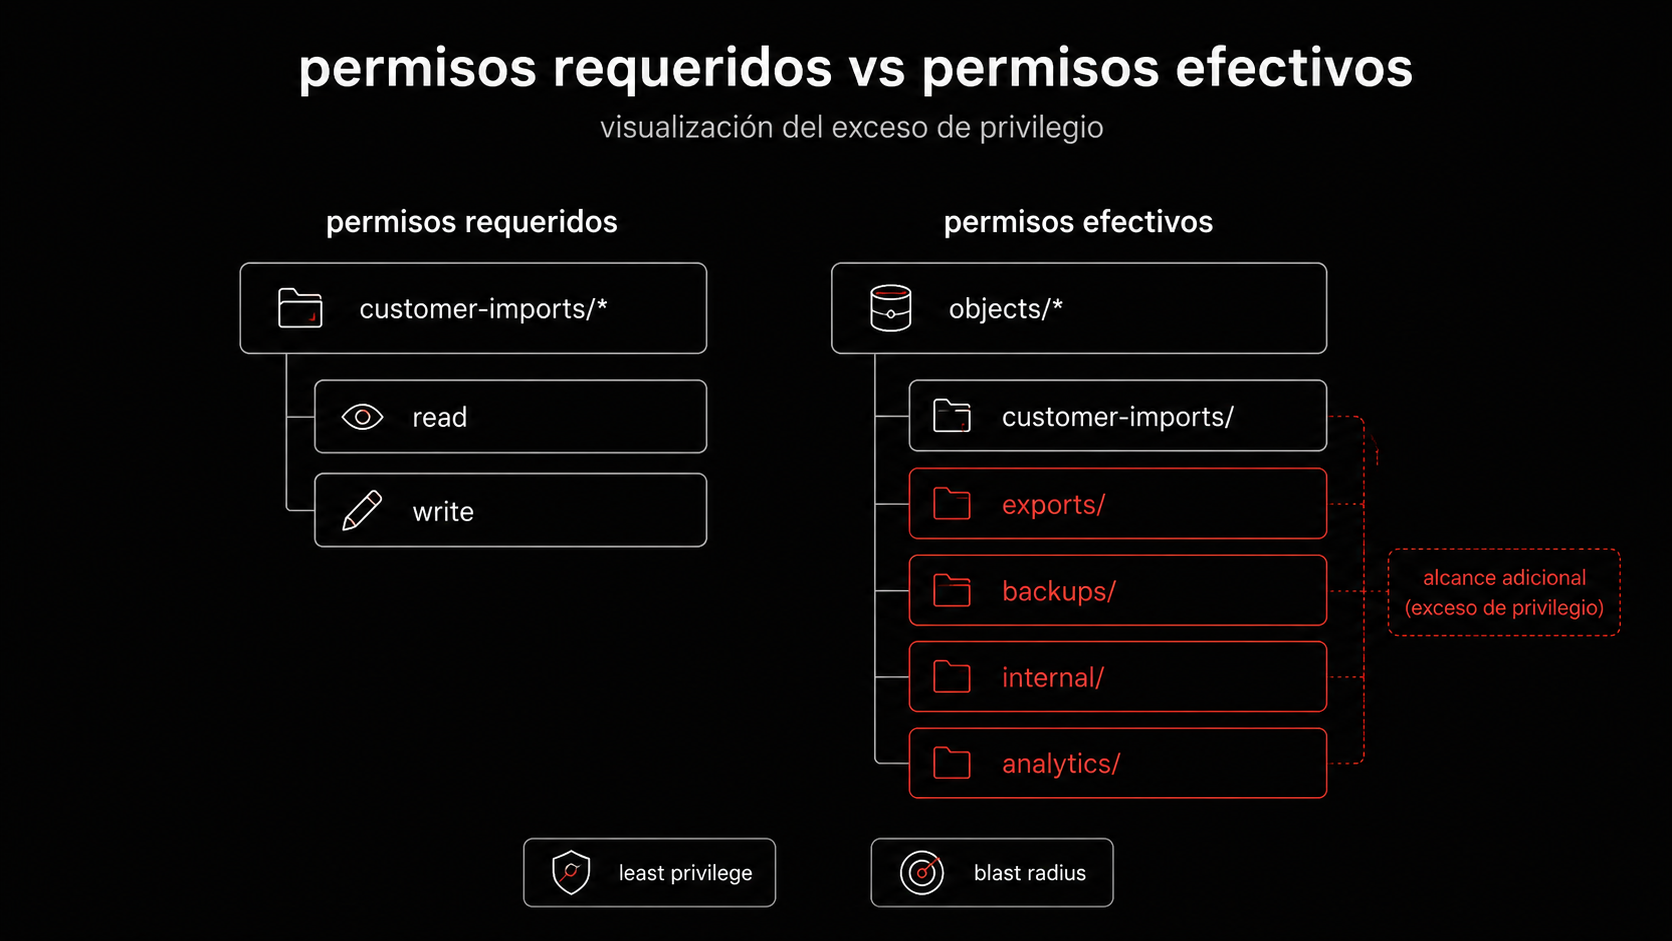 La diferencia entre ambos conjuntos define el exceso de privilegio.
Una política IAM demasiado amplia no implica automáticamente un compromiso. El riesgo aparece cuando una identidad con ese alcance puede alcanzarse desde una frontera de menor confianza.
En este caso, la cadena conectaba una identidad derivada de un flujo externo con permisos sobre recursos que pertenecían a dominios operativos distintos.
Eso permitía calcular el impacto en términos de blast radius, no únicamente en términos de acceso puntual.
Least privilege no significa que un rol tenga pocos permisos. Significa que tenga exactamente los permisos necesarios para su función y ningún otro.
11. Validación de impacto
Una vez reconstruida la cadena, seguir ampliando el acceso dejaba de aportar información relevante.
La validación se limitó a confirmar que la identidad podía ejercer permisos sobre recursos fuera de su función original.
No era necesario descargar conjuntos completos de datos, modificar información, desplegar persistencia ni realizar acciones destructivas. La propiedad de seguridad que debía comprobarse ya estaba rota: una identidad procedente de un dominio de confianza inferior podía actuar sobre recursos pertenecientes a otro dominio.
Ese punto es importante porque separa la demostración técnica del impacto de la explotación innecesaria.
La evidencia relevante era estructural.
Usuario externo
|
v
API legacy
|
v
Identidad de servicio
|
v
Control plane
|
v
Secretos operativos
|
v
IAM cloud
|
v
Recursos fuera del scope original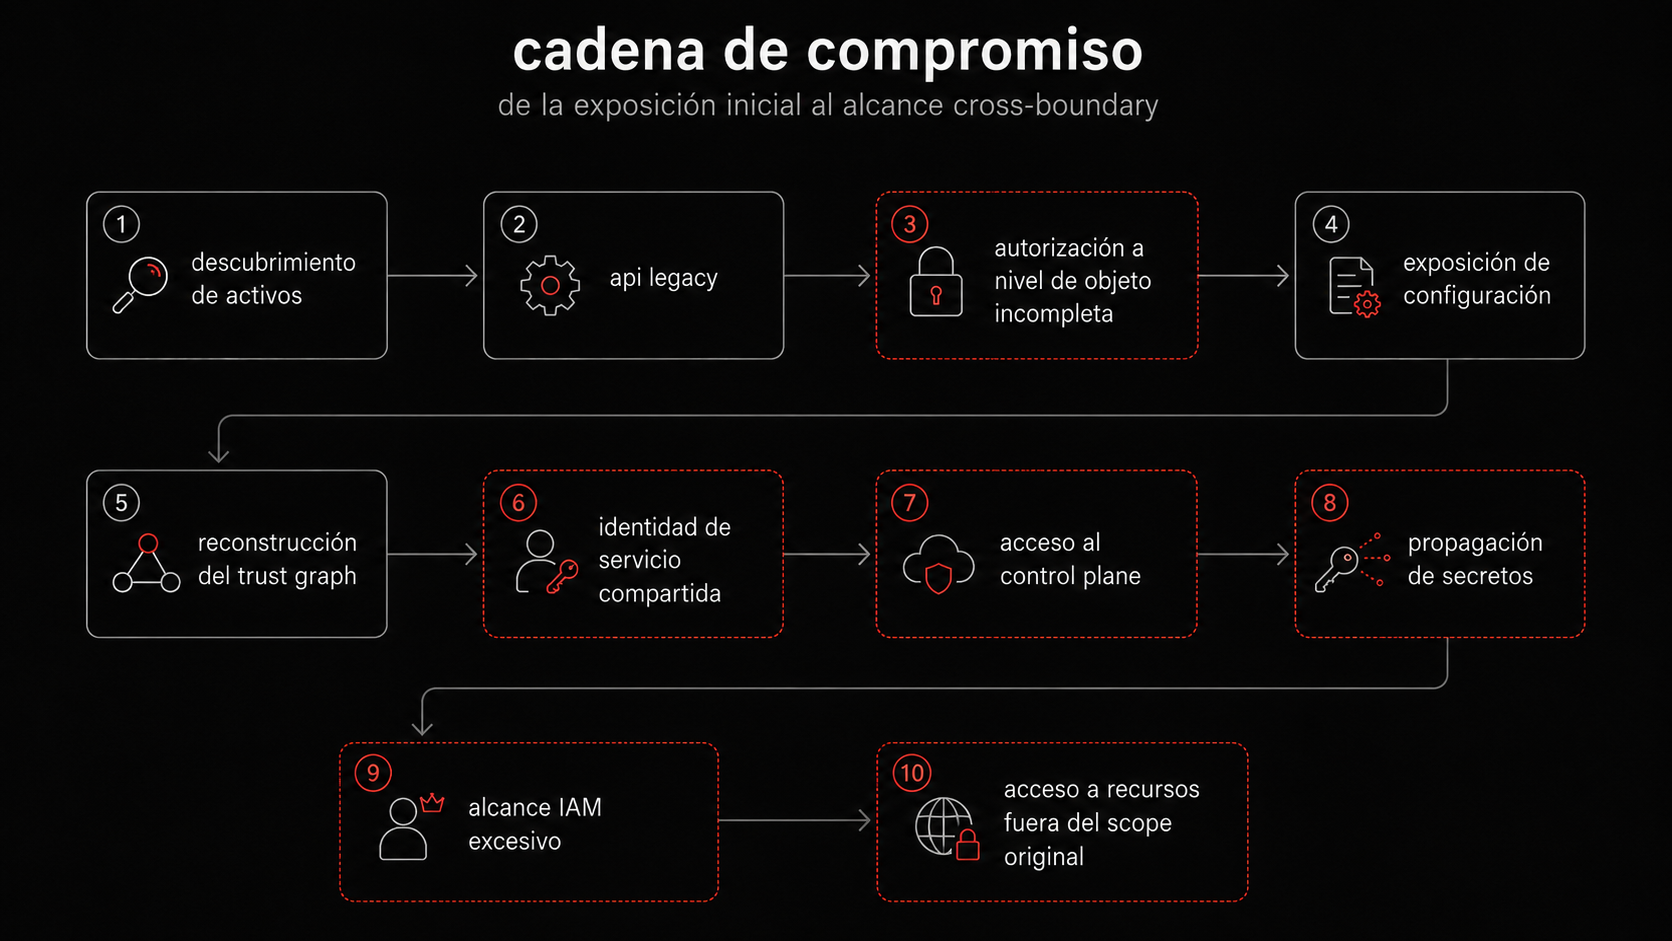 Una vez demostrado ese recorrido, incrementar el volumen de acceso no cambiaba la conclusión.
La validación termina cuando la hipótesis de seguridad queda demostrada, no cuando se agotan todas las acciones posibles.
12. Hallazgos correlacionados
Analizados de forma aislada, varios de los hallazgos no explicaban el impacto final. El riesgo apareció al componerlos dentro del mismo modelo de confianza.
La autorización incompleta aportaba contexto. El contexto permitía reconstruir dependencias. Las dependencias revelaban identidades reutilizadas. Esas identidades ampliaban el alcance hacia componentes administrativos y, finalmente, hacia permisos cloud superiores a los requeridos por la función original.
| ID | Hallazgo | Severidad | Rol en la cadena |
|---|---|---|---|
| F-01 | Activo legacy fuera del inventario principal | Media | Conserva dependencias históricas |
| F-02 | Autorización incompleta a nivel de objeto | Alta | Expone contexto cross-tenant |
| F-03 | Metadatos de arquitectura accesibles | Media | Reduce incertidumbre |
| F-04 | Identidad reutilizada entre servicios | Alta | Colapsa trust boundaries |
| F-05 | Acceso al control plane | Crítica | Amplía el alcance operativo |
| F-06 | Resolución innecesaria de secretos | Crítica | Propaga autenticación |
| F-07 | Política IAM con alcance excesivo | Crítica | Aumenta el blast radius |
La severidad real no podía evaluarse tomando cada hallazgo por separado. El problema era composicional.
Una arquitectura puede acumular fallos moderados y producir un impacto crítico cuando todos afectan a la misma cadena de confianza.
13. Por qué los controles existentes no fueron suficientes
La plataforma disponía de controles razonables: autenticación centralizada, capa perimetral, servicios principales actualizados, segmentación de red y gestión centralizada de secretos.
Ninguno de esos controles era inútil. El problema era que protegían componentes concretos, mientras que la cadena avanzaba a través de relaciones entre componentes.
La seguridad local era razonable. La seguridad composicional no.
La red separaba servicios, pero una identidad compartida reducía esa separación. El secret store restringía enumeración, pero seguía entregando material a una identidad con demasiado alcance. IAM limitaba acciones, pero el conjunto efectivo seguía siendo superior al requerido.
Un control puede funcionar exactamente como fue diseñado y seguir siendo insuficiente si el modelo de confianza que lo rodea es incorrecto.
14. Remediación por trust boundary
14.1 Inventario y decommissioning real
Un activo no debe considerarse retirado cuando deja de aparecer en documentación. Debe dejar de resolver, aceptar tráfico, mantener credenciales válidas y participar en relaciones de confianza.
14.2 Autorización centralizada
Los ownership checks no deberían depender de la implementación particular de cada handler. La política de autorización debe evaluarse de forma consistente sobre sujeto, recurso, tenant y acción.
14.3 Identidad independiente por workload
Cada servicio debería disponer de una identidad independiente, rotación independiente y permisos explícitamente limitados a su función.
Compartir credenciales entre workloads convierte compatibilidad operativa en transitividad de confianza.
14.4 Least privilege efectivo
La revisión de permisos no debería basarse únicamente en la policy declarada. Es necesario comparar permisos efectivos, recursos alcanzables y acciones realmente requeridas por el workload.
14.5 Secret minimization
Un proceso no debería poder resolver material de autenticación que no utiliza. La capacidad de obtener un secreto también forma parte del modelo de autorización.
14.6 Separación entre data plane y control plane
Las identidades orientadas a operaciones de usuario no deberían poder transicionar hacia componentes administrativos mediante credenciales compartidas, integraciones heredadas o políticas implícitas.
15. Conclusión
El aspecto más relevante del análisis no fue encontrar una vulnerabilidad especialmente novedosa, sino reconstruir cómo varias decisiones de arquitectura alteraban el alcance de cada hallazgo.
La autorización incompleta proporcionó contexto. Ese contexto permitió reconstruir relaciones. Las relaciones revelaron una identidad compartida. La identidad compartida redujo la separación entre planos. Los permisos efectivos terminaron ampliando el blast radius hasta recursos que no deberían haber sido alcanzables desde el flujo original.
La lección principal es que, en arquitecturas maduras, el análisis no puede limitarse a comprobar si cada componente está protegido de forma aislada.
También hay que estudiar qué propiedades de seguridad dejan de cumplirse cuando varios componentes correctos confían entre sí de una forma incorrecta.
La pregunta útil no siempre es qué componente está roto. A veces es qué relación de confianza permite que un fallo pequeño cambie de alcance.